想象一个秋后阳光明媚的屋内场景:两个婴儿躺在婴儿车中,窗帘没有拉严,一道光从缝隙里漏进来,落在墙上,微微晃动。一个婴儿久久地看着那道光。另一个婴儿,在同一时刻,把目光转向了俯身靠近的母亲的脸。
但从此,一个孩子反复练习的是追踪光影的移动,另一个孩子反复练习的是辨认表情、目光和声音里的意图。早期干预丹佛模式(ESDM)反复强调的正是:孩子最初把注意力投向哪里,学习就从哪里开始。 如果社会性信息长期没有被“看见”,社交沟通的学习机会就会在生命最早的那几年里悄悄流失。
眼动仪记录下的,正是这种“看向哪里”的差异。
屏幕上,一个年轻女子正在讲故事。她时而睁大眼睛,时而做出睡觉的动作,表情和手势不断变化。一群孩子看着同一段视频。研究人员将眼动记录叠加到画面上后,发现了不易察觉的差异:许多典型发育(TD)儿童把目光落在讲述者脸上;一名4岁的孤独症(ASD)儿童,却更多看向她的胸前(毛衣上有一排小人)。
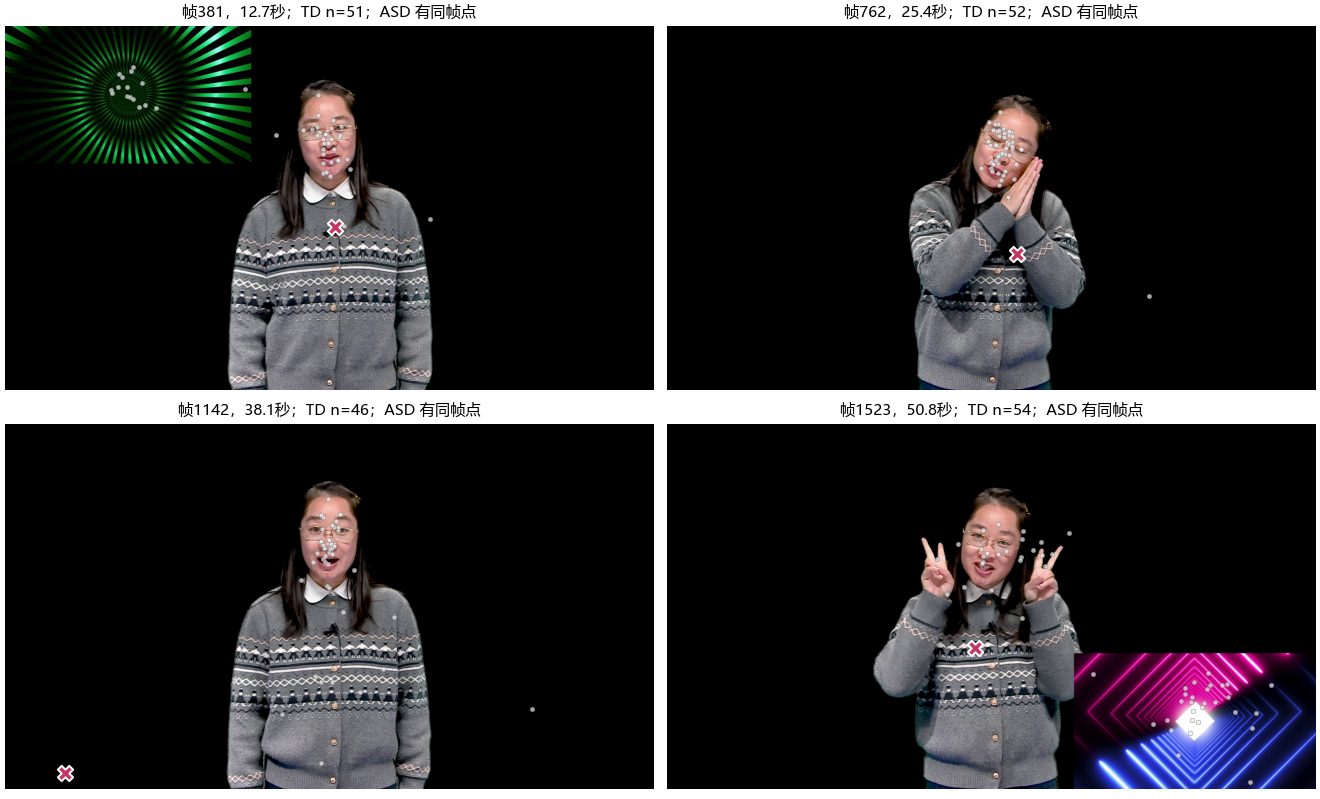
图1 真实视频中的四个时刻:浅色圆点是多名TD儿童的眼动落点,红色叉号是一名ASD儿童的落点。
他们面对的是同一段故事,进入视野的却可能是不同的信息。这一差异也并非偶然,该儿童观看的8段视频中,面部观看比例都低于同内容TD参考。
如果接收到的线索不一样,理解同一场景的过程就会有所不同。我们先弄清楚TD究竟怎样看。
孩子本来就不该一直盯着人脸
这份研究报告整理了127名典型发育儿童(TD)和18名孤独症谱系障碍儿童(ASD)观看8类视频的眼动记录:讲故事、搭积木、过生日、吹泡泡,以及更复杂的多人活动和几何图案场景。
一个最值得注意的发现是:TD儿童观看面部的比例会随着内容明显改变。讲故事时,面部观看比例的中位数约为48%;换成搭积木,就只有约9%;吹泡泡时还会更低。
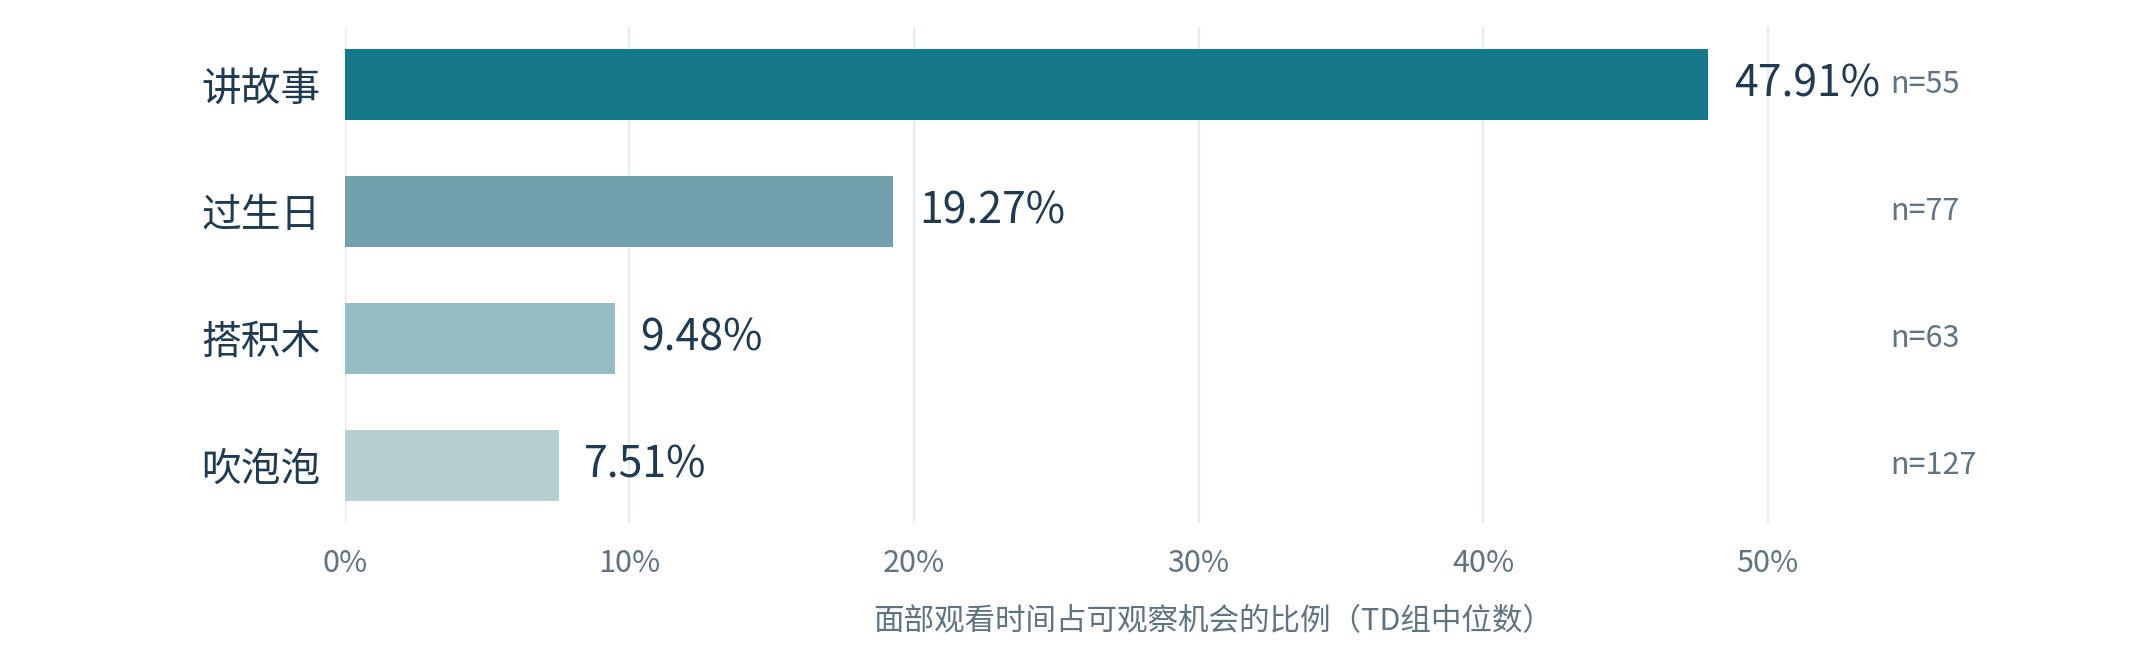
图2 TD儿童在不同视频中的面部观看比例。每个数值为该视频可评价儿童的中位数;n为人数。
这不是注意力突然变差了。听故事时,人物的表情、目光和口型携带大量交流线索;搭积木时,更关键的可能是手拿起哪块积木、怎样旋转、放在何处;吹泡泡时,目光自然会跟随活动中的运动物体。
因此,好的观看模式不是“始终看脸”,而是根据情境,把目光分配给有用的信息。
ASD与TD的差异在哪些情境里最明显?
正是在这个背景下,ASD与TD的比较才有意义。研究并不是要求所有孩子遵循一个固定的看脸比例,而是在相同视频内容中比较他们的眼动分配。
结果显示:讲故事时,16名可比较ASD儿童中有14名面部观看少于同内容TD参考;过生日时是17名ASD儿童中有15名少于同内容TD参考。但在动作与阅读视频中,这个数字下降为16名中的9名。差异并不会在每种情境里以同样方式出现。
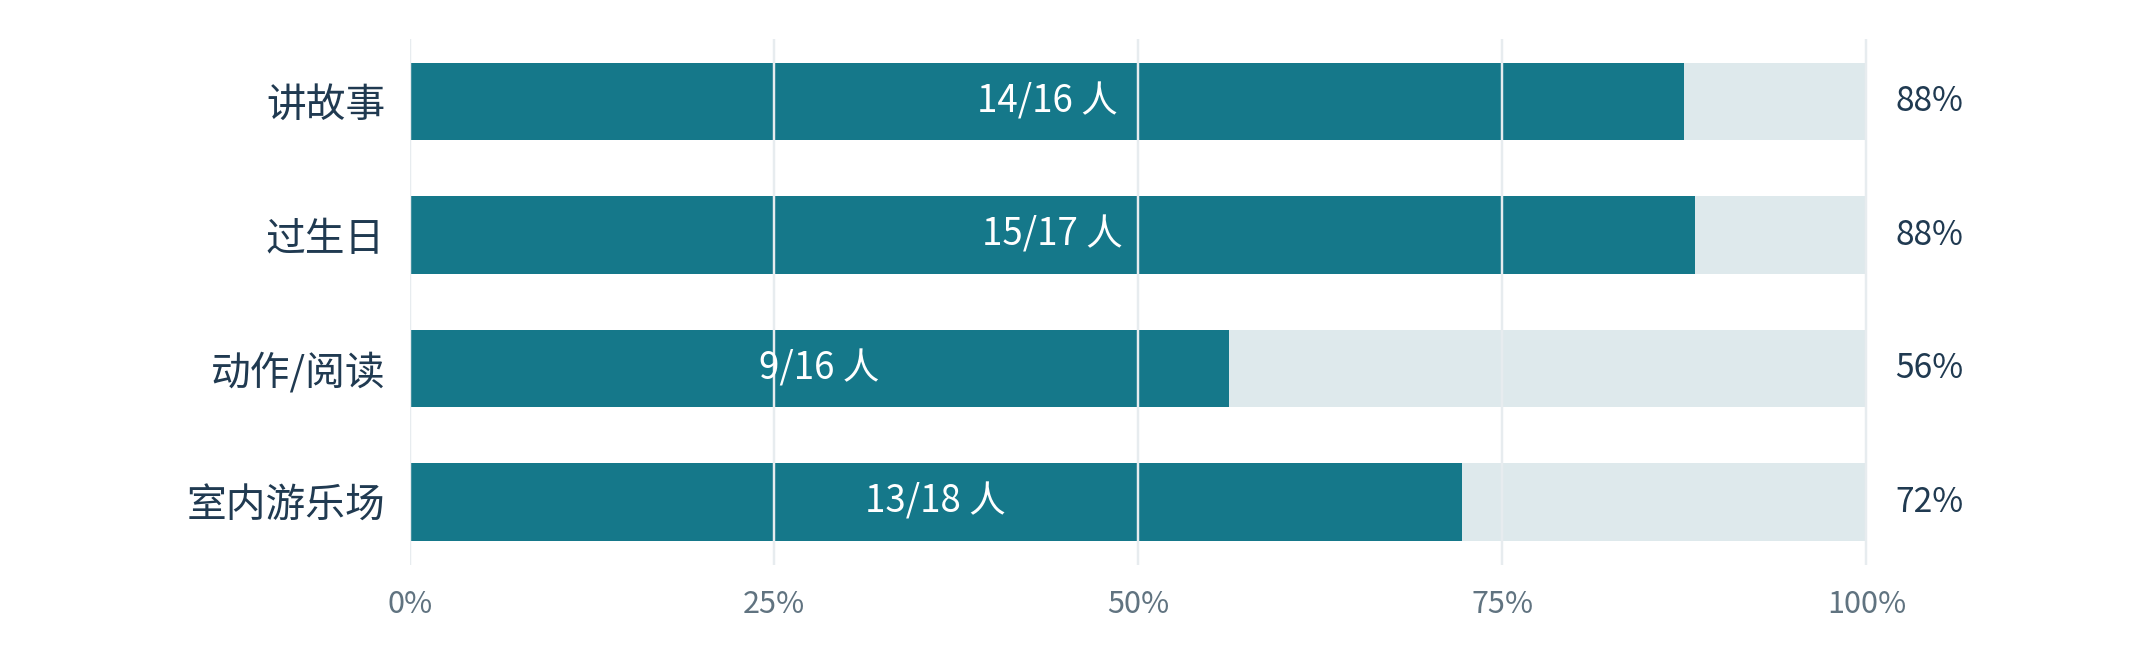
图3 各场景中“面部观看比例低于同内容TD参考”的ASD儿童人数。
将脸部细分后,还能看到:在满足跨视频比较要求的17名ASD儿童中,有14名的眼睛和嘴部观看比例较低。眼睛、嘴和整个面部并非完全相同的指标,但它们共同指向这批数据中较常见的一种视觉信息分配方向。
为什么这可能重要?想象一个孩子把画送给妈妈。妈妈笑着说“真漂亮”,他听到的不仅是三个字,还可能从笑容中获得鼓励;若妈妈露出疑惑,同样的话可能表达的是另外一种意思。
交流中的重要内容,常常分散在话语、表情、目光、手势和情境里。如果较少看向面部,就可能减少直接获得表情和口型视觉线索的机会。这并不证明孩子缺乏交流意愿,也不能直接判断他是否理解了对方的情绪。它只是把一个深层的问题具体化:一些社会沟通差异,可能从最初选择和获取视觉线索的环节就已出现。
错过的不只是面部,而是那个瞬间
“看了多久”和“什么时候看”,是两个不同的问题。两个孩子即使看脸的总时长一样,但是他们可能分别看到了人物最情绪化的瞬间和表情平静的时刻。
回到开头那名4岁ASD儿童的故事视频,找出TD儿童较一致地关注面部的时刻。整段视频中有38个这样的1秒时段。这名ASD孩子有34个时段可以评价,却只有1个时段看到了面部。
这不是“只看脸1秒”的意思,而是在34个可评价的群体关注时段中,只有1个时段他看向了面部。
社会信息不会停在原地等待。一阵短暂的惊讶、一个指向玩具的目光、几个人突然转头,都可能传递正在发生的变化。如果目光没有在相关时刻到达,孩子就可能没有取得那次视觉线索。
不过,眼动仪看到的是视线的到达和停留,不是大脑对意义的理解。要确认“看到了但没理解”,还是“没有看见”,还需要结合故事理解、表情识别和实际交流任务。
另一名ASD儿童,却给出了近乎相反的答案
如果文章停在这里,很容易得出一个错误而简单的结论:ASD儿童都不爱看脸。
但研究中的另一名3岁ASD儿童A03,在8段视频的同内容比较中,面部观看比例都高于TD参考。特别是在动作/阅读视频里,他对面部的整段观看比例为47.68%,而该视频TD组中位数为25.07%。
然而,同一视频里,他对手部的观看比例为13.93%,低于TD组中位数17.51%。这组数字并不能证明他的模仿能力存在困难,却提供了另一种观察线索。
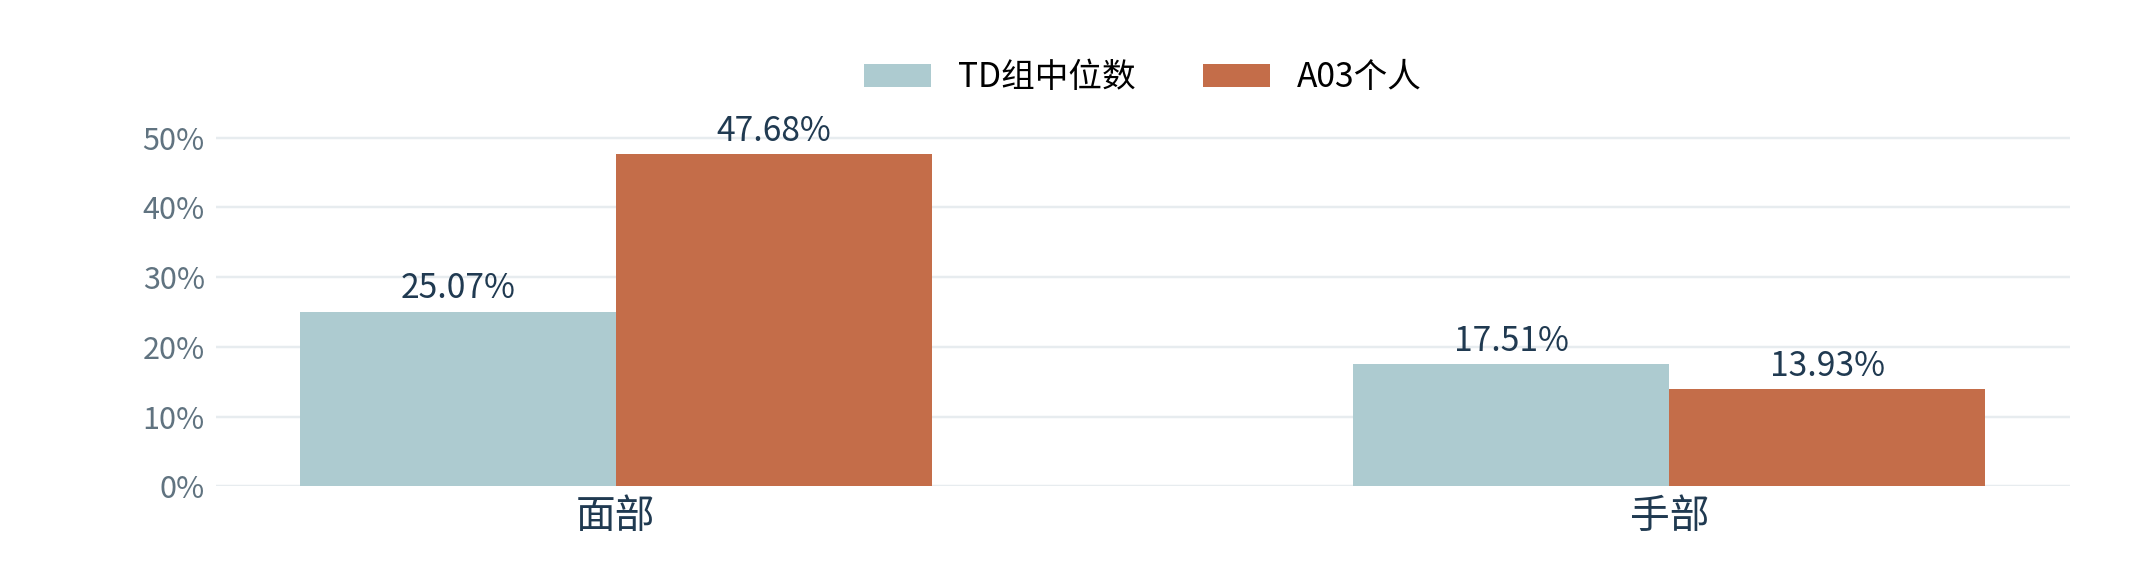
图4 A03与TD组在同一段动作/阅读视频中的整段面部、手部观看比例。TD为组中位数,A03为个人数值。
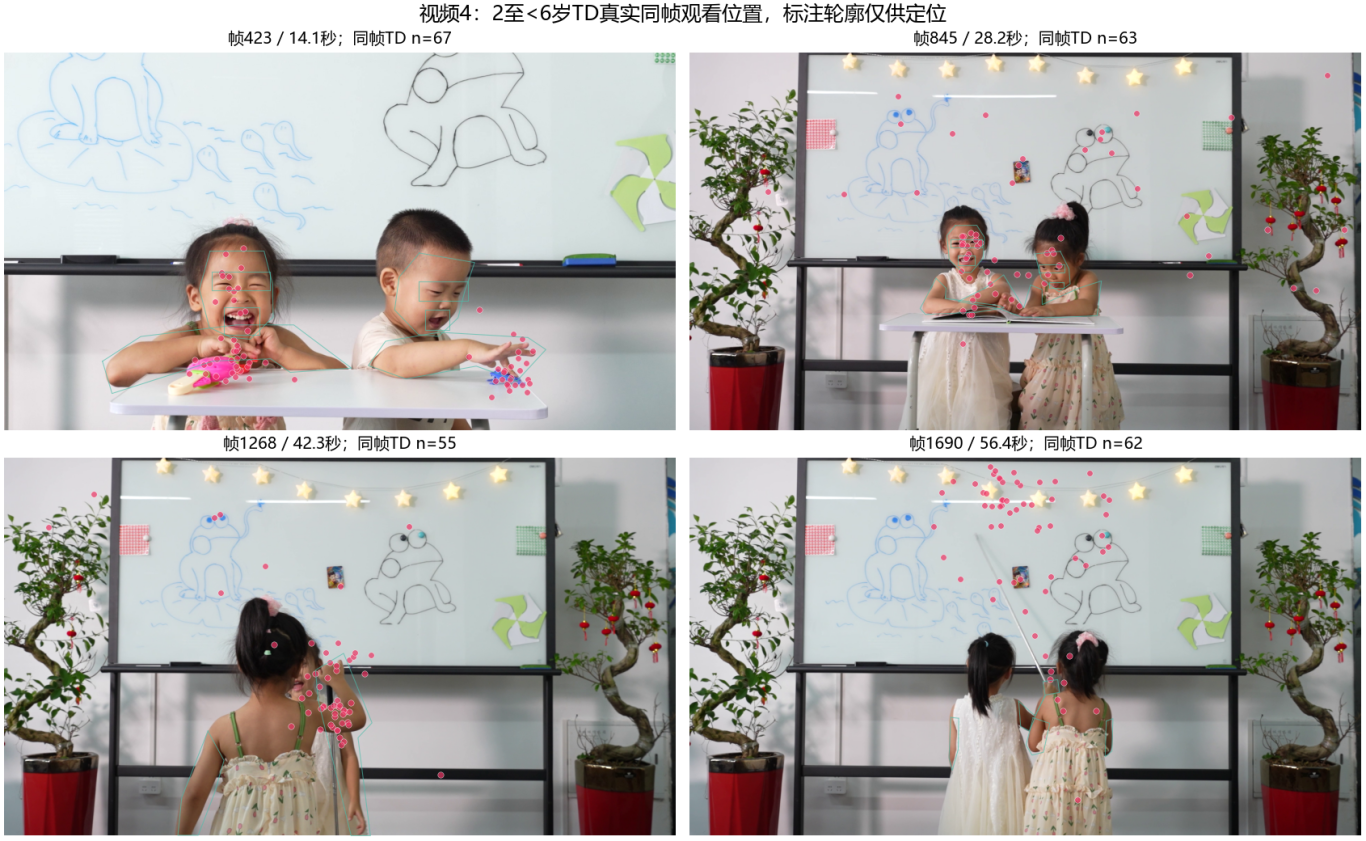
图5 动作/阅读视频的实际内容。面部与手部在不同片段都可能承载关键信息。
想象老师演示制作纸飞机:孩子一直看着老师的脸,知道有人在讲解,却可能较少看见纸张怎样折叠、手指怎样压住折痕。反过来,另一个孩子可能很留意手部步骤,却较少获取示范者表情中的提示。
两名ASD儿童的差异,不只是“看脸多少”的区别,更是他们各自取得哪类信息、可能漏掉哪类信息的区别。
但要特别小心,看手少不等于不会模仿,看脸少也不等于听不懂。真正发生了什么,仍需让孩子完成对应的理解或操作任务。研究中的个案也不能被直接当作已经确认的ASD临床亚型。
看得更广,为什么不一定看得更明白?
还有一条容易引起误解的发现,在17名有足够跨视频轨迹数据的ASD儿童中,有15名的目光空间展开程度高于匹配的TD参考。换句话说,他们的目光常出现在相距更远的位置。
不过,“看得更广”既不等于看遍整幅画面,更不等于取得了更多有用信息。目光可以在两处相距较远的位置反复往返,形成很大的展开范围,却并未接触第三个关键区域。
进一步分析了目光在画面网格之间的转移顺序,却没有发现ASD儿童一致地“更随机”:17人中9人的转移不确定性较高,8人转移不确定性较低。扩大搜索范围和改变信息组织方式,并不是同一件事。
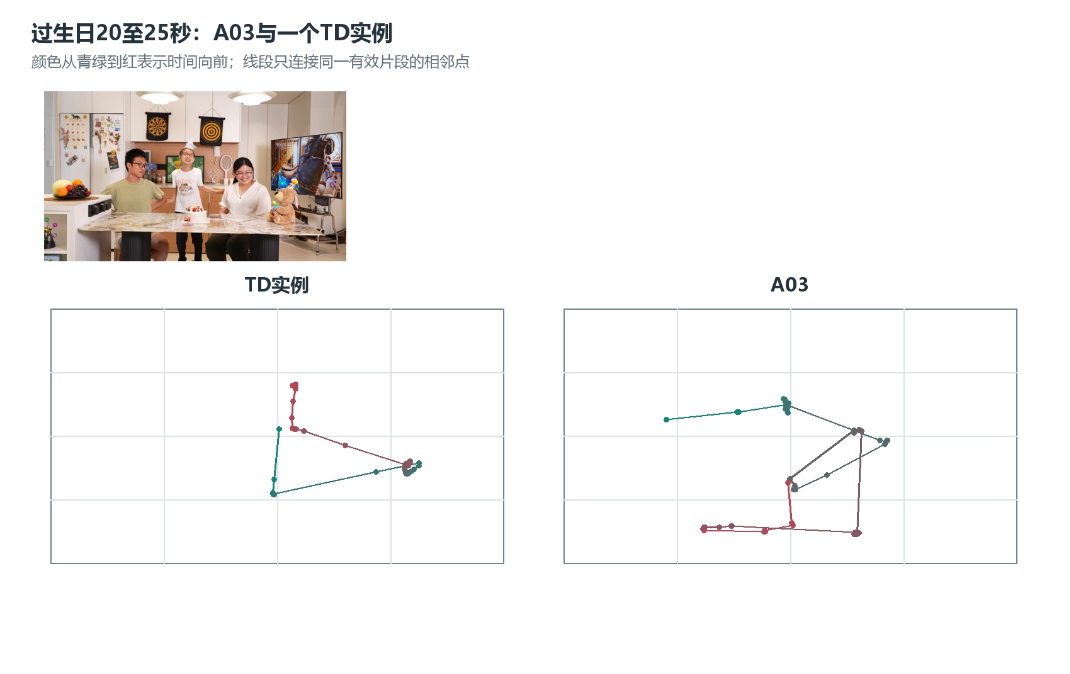
图6 同一生日视频20–25秒内,TD儿童与A03的真实扫描路径示例。
一个孩子可能在人物和物体之间快速来回,恰好跟上重要动作;另一个孩子也可能移动很多,却反复错过关键线索。仅凭路径长短,我们无法判断谁理解得更多。最该追问的是,这些目光移动有没有把前后发生的事情联系起来?
目光的差异,留下了哪些值得追问的问题?
同样一段视频,不同孩子的目光可能走过截然不同的路线,远比“看脸多还是少”更加丰富。即使是目光移动的范围、停留的节奏和返回的方式,也呈现出不同的个人特点。然而,眼动记录揭示的是视觉信息获取的过程,而不是理解本身。看到一张脸,不等于理解了表情;错过一次目光变化,也不意味着无法理解对方的意图。真正值得探索的问题,恰恰从这里开始。
首先,ASD儿童的观看差异,究竟发生在信息选择的哪个环节? 是某些社会线索较难吸引注意,还是注意已经转向其他对象,因而没有及时捕捉人物的变化?不同原因可能形成相似的眼动结果。
其次,观看方式的不同,是否真的影响了孩子对社会情境的理解? 如果两个孩子观看同一个故事,却关注不同的人物和动作,他们对故事情节、人物情绪和行为意图的理解是否也会不同?哪些眼动特征能够预测这种差异?
最后,能否从眼动差异中找到每个孩子更容易获取信息的方式? 当人物的表情、动作或语言提示发生改变时,孩子的目光是否会随之调整?这种调整能否帮助他更好地理解故事、学习动作或参与交流?
回到开头那名4岁ASD儿童。34个群体关注的瞬间里,他只有1个看向了脸。但另一名3岁ASD儿童,在动作视频里看脸的时间反而比TD组更长。同样的诊断标签,目光走向了不同方向。
眼动仪记录的是“看了哪里、看了多久”,真正值得追问的是:那个瞬间,他有没有把眼前的事,和之前、之后的事联系起来。
透过窗帘的光还是母亲的面孔,不是一道判断题,更像一道选择题。
(眼动仪记录下两种不同的观看路径。它们提示的问题,也许不是谁更专心,而是孩子怎样从复杂的画面中选择、更新和联系社会信息。)